El problema no es a cuál te vas. Es si puedes volver a salir.#
Salir de VMware no sirve de mucho si llegas a otro hipervisor con las mismas cadenas. Esa es la idea de este post.
Llevo meses viendo clientes en LATAM evaluar Nutanix, OpenShift Virtualization, Proxmox o KVM puro. Casi todas las conversaciones parten igual: “¿a cuál me voy?”. Y casi nadie pregunta lo importante: “¿cómo me aseguro de poder salir otra vez?”.
Porque seamos honestos. Si cambias VMware por otro stack cerrado, no saliste del lock-in. Solo cambiaste de dueño. Y el que viene también puede subir precios, cambiar licencias o cerrar una herramienta de un día para otro.
Eso último no es hipotético. Pasó hace un mes, con el VDDK. Vamos por partes.
Cambiar de dueño no es cambiar de modelo#
La mayoría de los planes de salida que veo son un salto directo: sacar las VMs de ESXi y meterlas en otro stack que también trae su consola, su storage y su licencia en el mismo paquete.

El salto directo resuelve el problema de este año. El diseño desacoplado resuelve el problema de los próximos diez. Y no es mucho más caro si lo haces mientras migras, porque igual vas a tocar cada VM.
No todo lock-in pesa lo mismo#
Cuando hablamos de “quedar amarrado” mezclamos cosas muy distintas. Separarlas es el primer paso para diseñar bien.
| Tipo de lock-in | Qué te amarra | Ejemplo típico | Cómo lo desacoplas |
|---|---|---|---|
| Formato de disco y VM | Discos y metadata que solo entiende un hipervisor | VMDK + VMX, snapshots propietarios | qcow2 o raw, drivers virtio, nada que dependa de una feature exclusiva |
| Acceso a los datos | Que para leer tus propios discos necesites un SDK de otro | VDDK en VMware | Rutas de copia que no dependan de ese SDK (lo vemos abajo) |
| Gestión y APIs | Scripts, consolas y automatización escritos contra una API cerrada | PowerCLI, vRO, Prism | Terraform y Ansible con providers por plataforma |
| Red y storage acoplados | Que la red o el storage solo existan dentro del hipervisor | NSX, vSAN, storage hiperconvergente propietario | Storage externo estándar (iSCSI, NFS, Ceph), red física o SDN abierta |
| Comercial | Licencias por núcleo, bundles, renovaciones forzadas | VCF obligatorio, mínimos de 16 cores | Contratos cortos, licencias portables, plan B probado |
Los primeros tres son los más traicioneros, porque no se ven en la factura. Se ven el día que intentas salir.
Y el segundo, el acceso a los datos, es el que casi nadie tenía en el radar hasta agosto.
VDDK: el lock-in que nadie veía#
El VDDK (Virtual Disk Development Kit) es la librería que permite leer discos de VMware desde afuera del hipervisor. Existe desde 2008 y casi todas las herramientas de backup y migración del mercado se apoyan en él.
El detalle es su licencia: no permite redistribuirlo. Ni Red Hat, ni Microsoft, ni ningún proyecto open source pueden empaquetarlo. Todos te decían lo mismo: “anda a la página de VMware, descárgalo y déjalo en esta carpeta”. Un solo punto de acceso, controlado por un solo dueño.
El 25 de agosto de 2026 ese punto de acceso se cerró. Broadcom bajó las páginas públicas de descarga del VDDK sin anuncio previo. Después le confirmó a TechTarget que el uso aprobado del VDDK siempre fue el backup y la recuperación, a través de sus partners del programa TAP. Migrar no está en esa lista.
¿Por qué esto duele tanto? Mira lo que dependía de esa descarga:
- MTV de OpenShift Virtualization: Red Hat recomienda fuertemente usarlo con VDDK, y las VMs sobre vSAN directamente no migran sin él.
- Azure Migrate: la migración sin agente apuntaba al portal de Broadcom. Su documentación ahora sugiere caer a migración con agente.
- Nutanix Move: también quedó sin su fuente de descarga, justo la herramienta de la plataforma que más aparece en las evaluaciones de la región.
- Herramientas open source como virt-v2v o migratekit: todas pedían que tú bajaras el VDDK a mano.
Resultado: migraciones que estaban a mitad de camino quedaron trabadas de un día para otro.

Dibujado así se entiende mejor el problema. No importa qué tan abierta sea la herramienta de migración: si su pieza crítica la controla otro, la puerta la cierra otro.
Ahora la parte incómoda. Esto lo hizo Broadcom, pero el patrón no es exclusivo de Broadcom. Cualquier plataforma donde la única forma de sacar tus datos pase por un SDK o una API que controla el fabricante te puede hacer lo mismo mañana. Ese es el criterio que hay que llevar a la evaluación del próximo hipervisor.
¿Cuánto te cuesta salir?#
Antes de hablar de arquitectura, ponle un número a tu lock-in. Una fórmula simple:
Costo de salida ≈ (VMs × horas por VM × costo hora) + (ventanas de corte × costo de downtime) + (horas para rehacer automatización) + (meses con licencias duplicadas × costo mensual)
Un ejemplo ilustrativo: 300 VMs × 3 horas × USD 40 la hora son USD 36.000 solo en mano de obra. Y eso sin contar ventanas, scripts que hay que reescribir ni los meses pagando dos plataformas a la vez.
Lo interesante es dónde actúa la arquitectura desacoplada: baja las horas por VM. Si el formato, los drivers y la automatización ya están resueltos, cada VM es casi un trámite. Ese número es el que tienes que llevarle a tu jefe.
Esto ya no es solo técnico, es regulatorio#
Aquí viene algo que muchos en la región no están conectando. Los reguladores financieros de LATAM llevan años pidiendo lo mismo que propongo en este post: que puedas salir de un proveedor tecnológico sin que se caiga la operación. La mayoría de estas normas nació pensando en la nube, pero el principio aplica igual a tu hipervisor: es un proveedor tecnológico crítico, y Broadcom acaba de demostrar que puede cambiarte las reglas de un día para otro.
| País | Norma | Qué exige, en corto |
|---|---|---|
| Brasil | Resolución CMN 4.893/2021 | Contratos de procesamiento y nube relevantes deben obligar, al terminar, a transferir los datos al nuevo proveedor o a la institución |
| Colombia | Circular Externa 005 de 2019 (SFC) | Estrategia de migración a otra plataforma si el contrato termina o el servicio se degrada |
| Chile | RAN 20-7 (CMF) | Externalización con planes de continuidad; para nube, plan de salida con portabilidad e interoperabilidad |
| Chile | Ley 21.663, Marco de Ciberseguridad | Los Operadores de Importancia Vital deben tener planes de continuidad certificados y revisados periódicamente |
| México | Disposiciones CNBV | Contratos de servicios tecnológicos con plan de terminación, mecanismos de transición y portabilidad |
| Unión Europea | DORA, artículo 28 | Estrategias de salida documentadas y probadas para servicios que soportan funciones críticas |
Tres cosas que vale la pena mirar con calma:
DORA es el referente que viene. Rige en Europa desde enero de 2025, y su exigencia clave no es tener un plan de salida en papel: es que esté probado. Varios bancos de la región son filiales de grupos europeos, así que esto ya les llega por la casa matriz. Y los reguladores locales suelen mirar hacia allá.
Chile se está moviendo. En abril de 2026 la CMF puso en consulta una actualización del capítulo 20-7 con enfoque de ciclo de vida del proveedor, reconocimiento de las “cuartas partes” y un nuevo reporte periódico de servicios externalizados. La tendencia es clara: más trazabilidad sobre de quién dependes y cómo sales.
El VDDK es el caso de libro. Si tu plan de salida de VMware dependía de una descarga que hoy no existe, tu plan de salida no era un plan. Si un auditor te pregunta mañana “¿cómo migran si el proveedor les corta una herramienta?”, la respuesta no puede ser “esperamos que no pase”.
Qué le mostraría yo a un auditor o al comité de riesgo:
- El inventario de dependencias del hipervisor actual, incluyendo VDDK y APIs propietarias.
- La ruta de salida elegida y por qué no depende de piezas que controla el proveedor.
- Evidencia de un restore real en otra plataforma, con fecha y tiempos medidos.
- La frecuencia con que se repite esa prueba.
La arquitectura: el hipervisor como pieza reemplazable#
La idea es simple de decir y difícil de hacer: que el hipervisor sea la capa más fácil de cambiar de todo tu stack, no la más difícil.

Lo que te deja la flexibilidad no es el hipervisor que elijas. Son las capas de arriba, de abajo y la de al lado. Bajado a tierra:
- Gestión: Terraform para aprovisionar (hay providers para Nutanix, Proxmox, libvirt y KubeVirt) y Ansible para configurar. Si mañana cambias de plataforma, cambias el provider, no reescribes la lógica.
- Cómputo: elige por operación y costo, sabiendo que es reemplazable. Si una feature solo existe en esa plataforma y tu negocio depende de ella, eso es lock-in, aunque sea muy cómodo.
- Formato de VM: qcow2 o raw, virtio como estándar de drivers y cloud-init para la configuración inicial. Una VM así arranca en KVM, AHV, OpenShift Virtualization o Proxmox sin drama.
- Storage y red: storage externo con protocolos estándar te deja conectar el cluster nuevo al mismo almacenamiento. Si tus datos viven dentro de un HCI propietario, migrar es copiar todo de nuevo.
- Backup agnóstico: la capa que más subestimamos. Si tu backup lee de un origen y restaura en varios destinos, cada restore es un ensayo de migración.
Dónde amarra cada plataforma#
Ninguna es “la mala”. Todas amarran en algún lado; lo importante es saber dónde, y si ese amarre te molesta o no.
| Plataforma | Formato de disco | Dónde te amarra | Cómo sales |
|---|---|---|---|
| KVM / oVirt / OLVM | qcow2 o raw | Operación y soporte: tu equipo tiene que dominar KVM, y oVirt hoy depende de la comunidad | Formatos abiertos, API de oVirt e imageio estándar |
| Nutanix AHV | vDisks dentro del storage distribuido de Nutanix | El stack completo: HCI, Prism y licencia van en un solo paquete | Exportar discos o restaurar desde un backup agnóstico |
| OpenShift Virtualization | Discos en PVC, vía KubeVirt | La plataforma OpenShift entera y su suscripción | KubeVirt es upstream y los discos se pueden exportar desde los PVC |
| Proxmox VE | qcow2, raw, ZFS o Ceph | Poco amarre técnico; el riesgo está en soporte y escala | Formatos abiertos, qemu-img y listo |
Fíjate en la tercera columna. En casi todos los casos el amarre no es el hipervisor en sí: es lo que viene pegado a él.
Rutas de salida que no dependen del VDDK#
Buena noticia: el VDDK no es la única forma de sacar tus VMs de VMware. Es la más cómoda, pero hay al menos otras cuatro.

- Backup vía partner TAP: aquí está la ironía. Broadcom dice que el uso aprobado del VDDK es backup y recuperación a través de partners. Bueno, usa eso. Un backup de Veeam lee tus VMs en vSphere de forma legal y, en la versión 13.x, restaura en Nutanix AHV, Proxmox VE, oVirt KVM, HPE Morpheus VM Essentials, XCP-ng, Citrix XenServer, Scale Computing HyperCore, Hyper-V y nubes públicas, con inyección de drivers virtio durante el restore para varios de esos destinos. Para OpenShift Virtualization hay un plug-in propio. Tu migración pasa a ser un restore.
- Copia asistida por storage: si tus datastores viven en un array iSCSI o FC, el array puede hacer la copia. vJailbreak de Platform9 ya ofrece ese modo sin VDDK, y MTV soporta mapeos de copy-offload. Ojo que NFS todavía es una limitante en algunos casos.
- Agente dentro del sistema operativo: más lento y más manual, pero no toca el VDDK. Es justo el plan B que hoy sugiere Azure Migrate.
- Migración a nivel de aplicación: para bases de datos y servicios críticos, a veces lo mejor es no mover el disco. Réplica nativa de la base de datos, o redeploy con tu IaC en el destino.
Una advertencia honesta sobre la primera ruta. Si tu backup es tu puerta de salida, el backup también tiene que ser portable. Revisa que restaure en varios destinos, que puedas exportar a formatos estándar y que la licencia se mueva contigo. Si no, solo subiste el lock-in una capa. Justamente por eso estoy construyendo Moov, que te cuento a continuación.
Moov: el backup como formato abierto#
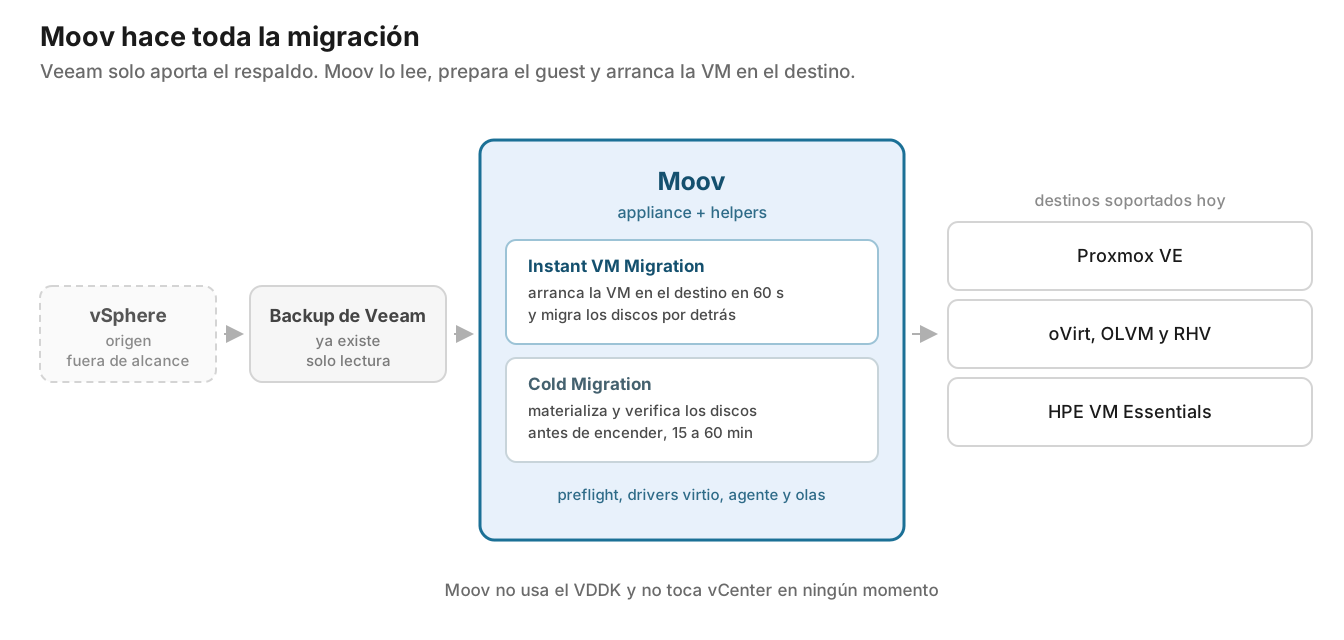
Moov nace de una pregunta simple: si ya tienes un backup de Veeam consistente de tus VMs, ¿por qué la migración tiene que volver a pasar por vCenter?
Moov lee ese respaldo que ya existe y migra la VM al destino. Hoy llega a Proxmox VE, oVirt (incluye OLVM y RHV) y HPE VM Essentials, en dos modos: Instant VM Migration, donde la VM arranca en el destino en 60 segundos o menos leyendo del backup mientras los discos migran por detrás, y Cold Migration, que materializa y verifica los discos antes de encender. Y sí, el nombre es un guiño: moov, “muu”, y la vaca que vive dentro de qcow2.
Lo que me interesa de este enfoque, más allá de la herramienta:
- No toca el origen: trabaja sobre el archivo de backup. No necesita VDDK, ni credenciales de vCenter, ni ventanas sobre producción.
- El backup pasa a ser tu plan B real: cada respaldo deja de ser solo protección y se vuelve una salida que además puedes ensayar.
- Está pensado para flotas: el Preflight Inspector clasifica qué VM es candidata antes de comprometer una ventana, y los helpers migran en olas, en paralelo.
¿Y por qué no usar directamente el restore nativo de Veeam, que ya llega a esos destinos? Porque resuelven cosas distintas. El restore nativo recupera una VM desde la consola, y funciona muy bien. Moov está hecho para mover cientos: clasificar la flota, planificar olas, arrancar en segundos y dejar las VMs listas para operar, sin pasar por vCenter. Donde el restore resuelve un caso, Moov resuelve un proyecto.
Está en beta pública (v1.0.40), bajo licencia MIT, y lo puedes bajar en moov.do. Si quieres el detalle completo de arquitectura, helpers, RBAC y puertos, lo conté en este post.
Si tienes un escenario para piloto, escríbeme. Me sirve mucho probarlo con casos reales de la región.
La caja de herramientas, capa por capa#
No necesitas todo esto el primer día. Pero si armas tu arquitectura, esta es la lista desde donde partiría yo.
| Capa | Herramienta | Para qué la usas | ¿Depende del VDDK? |
|---|---|---|---|
| Gestión | Terraform / OpenTofu | Aprovisionar VMs y redes con un provider por plataforma | No |
| Gestión | Ansible | Configurar SO y aplicaciones igual en cualquier destino | No |
| Formato | qemu-img | Convertir discos entre VMDK, VHDX, qcow2 y raw | No |
| Formato | cloud-init y drivers virtio | Primer arranque y drivers estándar en cualquier KVM | No |
| Migración | MTV (OpenShift Virtualization) | Migrar desde vSphere a OpenShift en olas | Sí: recomendado, y obligatorio con vSAN |
| Migración | virt-v2v | Convertir VMs a KVM e inyectar virtio | Solo en uno de sus modos de entrada |
| Migración | vJailbreak (Platform9) | Migrar desde vSphere a Private Cloud Director | Tiene modos sin VDDK |
| Protección | Veeam Backup & Replication | Respaldar en un hipervisor y restaurar en otro | Lo usa como partner TAP; tú no lo descargas |
| Portabilidad | Moov | Migrar VMs respaldadas por Veeam a Proxmox, oVirt y HPE VM Essentials | No |
La última columna es la que yo agregaría a cualquier evaluación de herramientas desde hoy en adelante.
Los errores que siempre muerden#
- Windows sin drivers virtio. El clásico: la VM llega a KVM y no arranca porque no ve el disco. La solución manual es instalar los drivers virtio antes de migrar. Si migras con Moov, esto ya está resuelto: se encarga de los drivers durante la conversión, así que la VM llega lista para arrancar.
- Linux sin virtio en el initramfs. Mismo problema, distinto sistema. Regenera el initramfs con los módulos virtio antes del corte.
- La red cambia de nombre. En Linux,
ens192pasa a ser otra cosa. En Windows, la IP queda pegada a una NIC fantasma. Documenta las IPs antes y valida después. - BIOS vs. UEFI. Si la VM bootea en UEFI en VMware y la creas en BIOS en el destino, no arranca. Copia el modo de firmware.
- Licencias por hardware. Windows puede pedir reactivación por el cambio de hardware virtual. Y con Oracle Database, ojo: Oracle solo reconoce el particionamiento duro en algunas tecnologías, como su propio KVM. En otros hipervisores podrías terminar licenciando todos los cores del host. Revísalo con tu contrato antes de mover una base.
- VMware Tools que quedan. Desinstálalas después de migrar; en algunos casos dan problemas de rendimiento o servicios que no arrancan.
Cómo lo bajas a un plan#
Todo esto suena bien en papel. Para que no quede ahí, yo lo ordenaría en cinco fases.

- Inventario: lista qué depende de VMware más allá de las VMs. Scripts de PowerCLI, integraciones con vCenter, herramientas que usan VDDK, appliances que solo existen como OVA.
- Desacoplar: mueve la automatización a Terraform y Ansible, define qcow2 y virtio como estándar, y saca el storage del hipervisor donde se pueda.
- Piloto: elige un par de VMs reales y haz un restore completo en el destino. Mide tiempos, revisa drivers y red. Este es el momento de descubrir sorpresas, no en producción.
- Migración por olas: parte por lo menos crítico y sube de a poco. Cada ola deja lecciones para la siguiente.
- Salida probada: esta fase no termina. Ensaya cada cierto tiempo un restore en un hipervisor distinto al que usas. Si falla, vuelves a la fase 2 para esa capa.
La fase 5 es la que convierte todo el ejercicio en arquitectura, y no en un proyecto de migración más.
Para cerrar#
No te voy a decir a qué hipervisor irte. Nutanix, OpenShift Virtualization, Proxmox y KVM tienen buenas razones para existir, y la mejor opción depende de tu equipo y tu operación.
Lo que sí te digo es esto: la decisión importante no es el destino. Es que el destino no sea el último. Diseña para que el hipervisor sea una pieza más, reemplazable, y que tus datos, tu automatización y tu backup vivan por encima de él.
Lo de agosto con el VDDK fue el recordatorio. El próximo puede venir de cualquier lado.
¿Ustedes cómo lo están planteando? ¿Ya probaron restaurar en un hipervisor distinto, o todavía está en la lista de pendientes?
Preguntas frecuentes#
¿Qué es el VDDK y por qué importa para salir de VMware?
El VDDK (Virtual Disk Development Kit) es la librería que permite leer discos de VMware desde fuera del hipervisor. Existe desde 2008 y casi todas las herramientas de backup y migración se apoyan en él. Importa porque su licencia no permite redistribuirlo: cada herramienta te pedía descargarlo tú mismo desde el portal de VMware, lo que creó un único punto de acceso controlado por un solo proveedor.
¿Qué pasó con el VDDK en agosto de 2026?
El 25 de agosto de 2026 Broadcom retiró las páginas públicas de descarga del VDDK, sin anuncio previo ni periodo de transición. Después confirmó a TechTarget que el uso aprobado del SDK siempre fue el backup y la recuperación a través de sus partners del programa TAP. El acceso quedó restringido a esa lista de partners aprobados.
¿Qué herramientas de migración se vieron afectadas?
Las que dependían de que el usuario descargara el VDDK: el Migration Toolkit for Virtualization de OpenShift Virtualization, Azure Migrate en su modo sin agente, Nutanix Move y proyectos open source como virt-v2v y migratekit. Varias migraciones que estaban a medio camino quedaron trabadas de un día para otro.
¿Se puede migrar desde VMware sin usar el VDDK?
Sí, hay al menos cuatro rutas abiertas. Restaurar desde un backup de un partner TAP (por ejemplo Veeam, que lee vSphere de forma legal y restaura en Proxmox, oVirt, Nutanix AHV, HPE VM Essentials y otros), copia asistida por el storage cuando los datastores viven en un array iSCSI o FC, un agente dentro del sistema operativo, o migración a nivel de aplicación con réplica nativa de la base de datos.
¿Qué exigen los reguladores de LATAM sobre salir de un proveedor?
Brasil (CMN 4.893/2021), Colombia (Circular Externa 005 de 2019), Chile (RAN 20-7 de la CMF y la Ley 21.663) y México (disposiciones CNBV) piden lo mismo con distintas palabras: estrategia de migración, portabilidad de los datos y planes de terminación. DORA, en Europa, va un paso más allá y exige que la estrategia de salida esté documentada y probada, no solo escrita.
¿Cómo hago que mi hipervisor sea una pieza reemplazable?
Desacoplando las capas que lo rodean: automatización en Terraform y Ansible en vez de scripts contra una API propietaria, formato de VM portable con qcow2 y drivers virtio, storage y red con protocolos estándar fuera del hipervisor, y un backup que lea de un origen y restaure en varios destinos. Con eso, cambiar de hipervisor deja de ser un proyecto y pasa a ser una decisión.


